Notizen aus der Entwicklung
DeepSeek V4: KI-Spielgenerierung mit kleinem Budget optimieren
Wir haben DeepSeek V4, Grok, MiMo, GLM und Claude Haiku im OpenGame Studio getestet, um kostengünstige Spielgenerierung zu optimieren – mit echten Screenshots und Fehlerfällen.
Können erschwingliche Modelle Browser-Spiele erstellen, die Menschen wirklich spielen möchten? In der vergangenen Woche haben wir diese Frage im OpenGame Studio untersucht. Die neueste Ergänzung ist DeepSeek-V4.1-Flash-1017, die am 17. Oktober erschienene Version aus der DeepSeek-V4-Familie.
Außerdem haben wir Grok 4.6, Xiaomi MiMo V2.6 Flash, MiMo V2.6 Pro, GLM 5.3 Flash und Claude Haiku 5.5 getestet. Ziel war es, ein besseres Verhältnis zwischen Generierungskosten, Wartezeit, Spielbarkeit und visueller Qualität zu finden. Ein Spiel kann sich erfolgreich öffnen und trotzdem nach rechts laufen, wenn der Spieler links drückt, Münzen zu früh gutschreiben oder während einer Pause weiterfallen.
Der aktuelle Runner von DeepSeek bestand die zentralen Gameplay-Prüfungen, die wir durchgeführt haben. Die Grafik war eher schlicht. In früheren Experimenten zeigten sich andere Probleme, darunter ein Fehler in unserer eigenen Auslieferungsvalidierung. Diese Details sind für Creator hilfreicher als eine unbegründete Rangliste von Modellen.
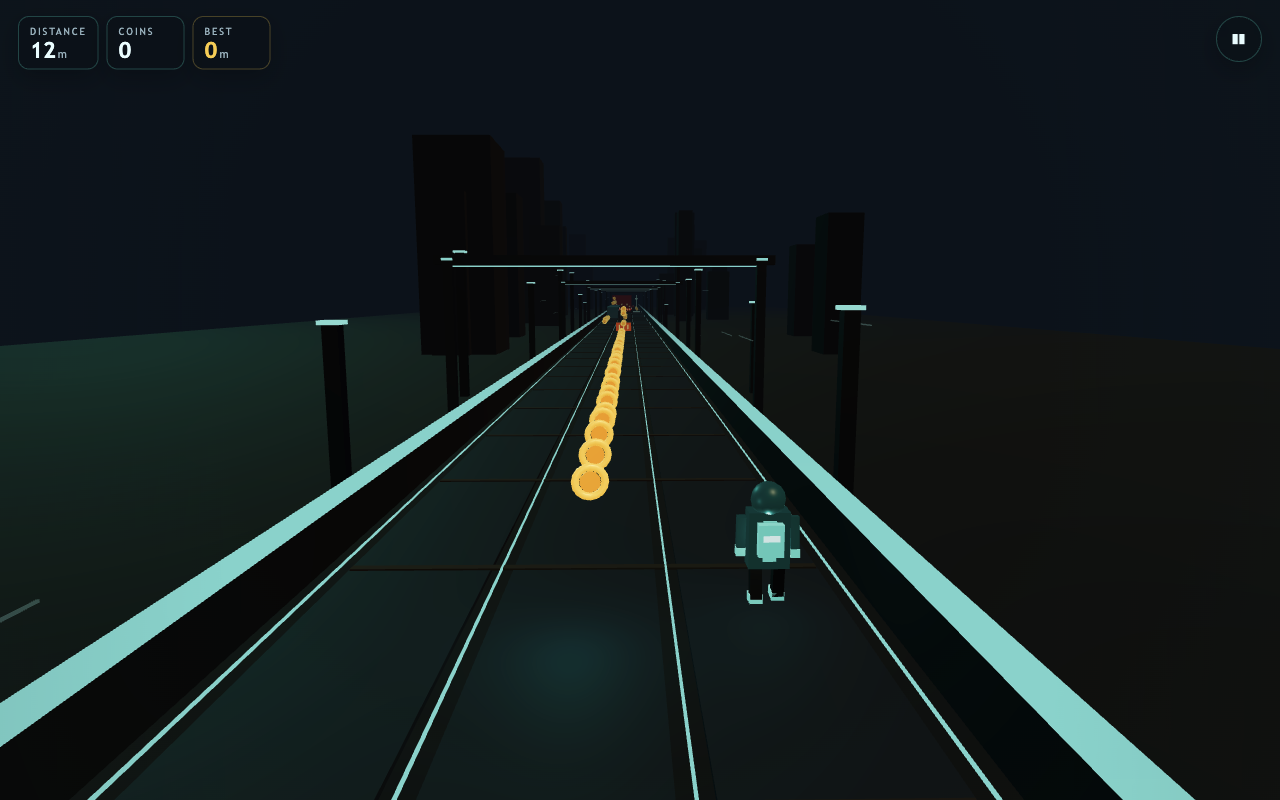
Der ursprüngliche Runner von DeepSeek-V4.1-Flash-1017. Figur, Spuren und Münzen sind unterscheidbar; die Umgebung ist noch einfach gehalten.
KI-Spielgenerierung mit kleinem Budget optimieren
Für kleine Spieleentwickler sind wiederholte Experimente wichtig. Bei der ersten Version müssen Kamera, Steuerung, Kollisionsregeln oder Art Direction vielleicht noch angepasst werden. Die praktische Frage ist, wie viel brauchbares, testbares Spiel dabei entsteht.
Ein leistungsstarkes Spitzenmodell wie Claude Opus 5.5 ist eine naheliegende Alternative für anspruchsvolle Programmieraufgaben. In seiner offiziellen Beschreibung wird auch die Arbeit mit Subagents behandelt. Bevor wir einen umfangreicheren Ablauf auswählten, wollten wir eine günstigere Vorauswahl untersuchen. Ein Modellname garantiert kein gutes Spiel. Auch der Einsatz mehrerer Agenten ist eine Ablaufentscheidung, die zusätzlichen Aufwand und Verbrauch verursachen kann.
Unsere Vorauswahl umfasste unterschiedliche Rollen:
- Grok 4.6 diente als vielseitige Referenz. Für uns war es eine weniger stark auf ein kleines Budget ausgerichtete Wahl, deren Reiz zum Teil im Zugang über ein Abonnement lag. Die offizielle Ankündigungsseite beschreibt Programmierzugriff über Grok Build und weitere Werkzeuge.
- Xiaomi MiMo V2.6 Flash und Pro ermöglichten uns, zwei Optionen derselben Familie zu vergleichen. Xiaomi positioniert Flash für effiziente, häufige Nutzung und Pro für anspruchsvolleres Schlussfolgern und Projektarbeit. Pro ist ein Spitzenmodell innerhalb seiner Familie, blieb aber Teil unserer Untersuchung günstiger Optionen.
- GLM 5.3 Flash bot eine weitere effizienzorientierte Möglichkeit. Die offizielle Vorstellung erläutert diese Positionierung. Wir wollten sehen, wie es mit dem vollständigen Spielauftrag umging.
- Claude Haiku 5.5 ergänzte eine internationale, kostenbewusste Option. Anthropic empfiehlt Haiku für schnelle Aufgaben mit hohem Durchsatz. Wir testeten es als Spieleentwickler und nahmen eine eingeschränkte Prüfung vor, die weiter unten beschrieben wird.
- DeepSeek-V4.1-Flash-1017 war unser neuestes Experiment. Die Veröffentlichungsankündigung enthält Projektbeispiele. Wir nutzten unseren eigenen Runner-Auftrag, um zu prüfen, was sich auf das OpenGame Studio übertragen lässt.
Weil der Preis mehrere Modelle aus China auf unsere Vorauswahl brachte, sind hier mehr Modellfamilien aus China vertreten. Das spiegelt unser Auswahlverfahren wider und ist keine Schlussfolgerung über die Modellqualität nach Herkunftsland.
Ein Runner, sechs Modellexperimente
Unser gemeinsames Spiel hieß Colossal Runner: ein eigener Endless-Runner aus der Third-Person-Perspektive mit drei Spuren. Die Figur bewegt sich automatisch vorwärts. Spieler wechseln die Spur, springen über Barrieren, rutschen unter Hindernissen über Kopfhöhe hindurch, sammeln Münzen und starten nach einem Zusammenstoß neu. Tastatur und Touch-Steuerung sollten dasselbe sichtbare Ergebnis liefern.
Der ursprüngliche Auftrag enthielt außerdem Pause, Wiederbelebungen mit verdienten Münzen sowie ein riesiges Hindernis, das zwei Spuren blockiert und eine sichere Route übrig lässt. Diese ineinandergreifenden Regeln machen den Auftrag aufschlussreicher als eine bewegte Szene mit Punktestand.
Für die folgenden Experimente vom 11. bis 17. Oktober 2026 verwendeten wir denselben eigenen Auftrag erneut:
| Experimentelles Modell | Bauzeit in diesem Lauf | Was die Belege stützen |
|---|---|---|
| Grok 4.6 | 13 Min. 28 Sek. | Lieferte eine spielbare Szene; links und rechts waren bei Tastatur und Touch vertauscht. |
| MiMo V2.6 Flash | 28 Min. 13 Sek. | Lieferte das Spiel; Münzen konnten vor der Berührung gutgeschrieben werden. |
| MiMo V2.6 Pro | 21 Min. 14 Sek. | Lieferte das Spiel; die Figurenphysik lief während der Pause weiter. |
| GLM 5.3 Flash | 25 Min. 08 Sek. bis zur Ablehnung | Unser Website-Validator lehnte die Auslieferung irrtümlich ab. Eine separate Prüfung des wiederhergestellten Originals fand eine veraltete Münzanzeige nach einem Neustart. |
| Claude Haiku 5.5 | 8 Min. 09 Sek. | Lieferte eine Vorschau mit sichtbarem Startbildschirm. Der Test endete nach der ersten Begutachtung; das Gameplay wurde nicht vollständig geprüft. |
| DeepSeek-V4.1-Flash-1017 | 7 Min. 03 Sek. | Lieferte das Spiel und bestand die von uns durchgeführten Prüfungen von Richtung, Hindernissen, Pause, Wiederbelebung und Neustart. |
Dies sind einzelne, von Entwicklern durchgeführte Experimente. Sie ermöglichen einen praktischen Vergleich, haben aber klare Grenzen: Jedes Modell erstellte seine eigene Spezifikation und Umsetzung, darunter unterschiedliche visuelle Entscheidungen. Die Tests fanden an verschiedenen Tagen statt, und die Website-Umgebung war nicht eingefroren. MiMo Flash benötigte vor dem Bau ein weiteres Gespräch. Die Zeiten enthalten weder Gespräch noch Spezifikation oder Spieltests; beim GLM-Wert endet die Messung mit der Ablehnung.
Für den DeepSeek-Runner behielten wir die bestehenden Generierungseinschränkungen und dieselben Anweisungen für den 3D-Builder bei wie für die MiMo-Experimente. Vor der Abnahmeprüfung wurde der Quellcode nicht manuell repariert. Diese Serie ergibt keine statistisch belastbare Rangliste für Geschwindigkeit oder Qualität.
Was MiMo, GLM und Haiku zum Gesamtbild beitrugen
MiMo Flash erzeugte ein überprüfbares Spiel mit brauchbarer Steuerung, darunter eingeschränkte Prüfungen von Tastatur, Touch und Pause. Problematisch war die Münzregel: Belohnungen konnten eintreffen, bevor der Runner eine Münze erreichte. Bei der Prüfung des Einsammelns las der Quellcode das falsche Positionsfeld aus. Eine überzeugende Szene und ein steigender Zähler hatten eine fehlerhafte Interaktion verdeckt.
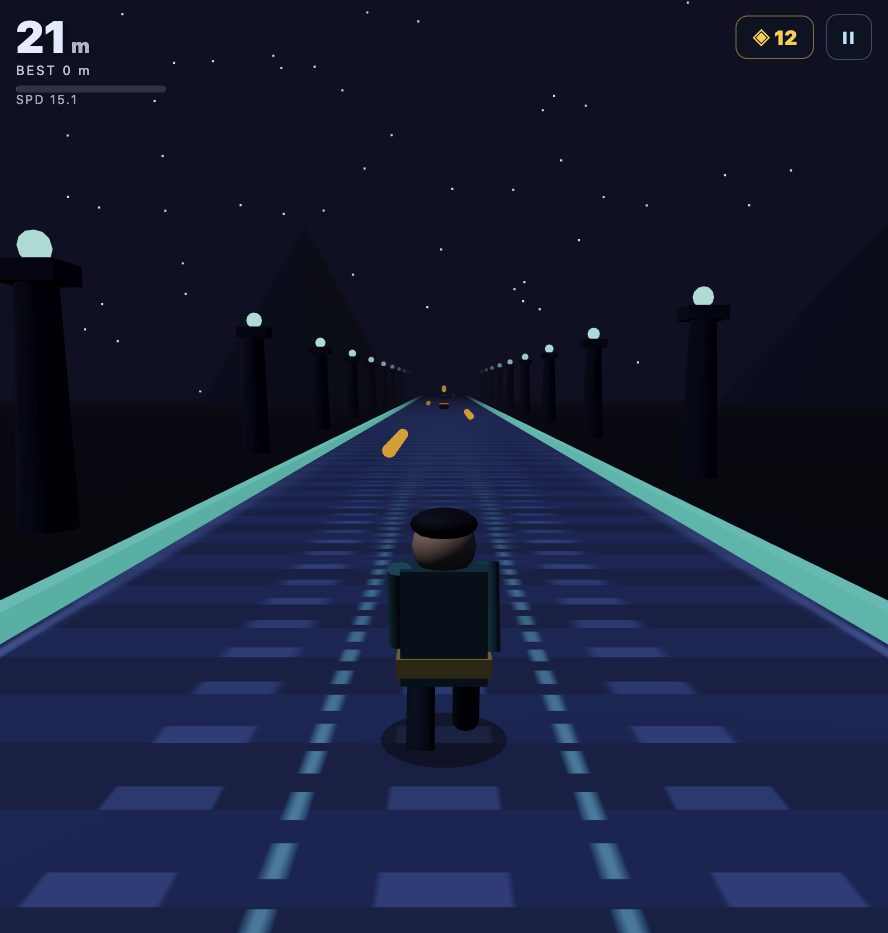
Originalausgabe von MiMo Flash vor späteren, kuratierten Reparaturen. Der Fehler beim Einsammelzeitpunkt zeigte sich in Gameplay- und Quellcodeprüfungen; dieses Einzelbild allein kann ihn nicht belegen.
Auch MiMo Pro lieferte einen spielbaren Prototyp, und die Prüfungen der Richtung sowie der Münzberührung waren vielversprechend. Eine Pause mitten in der Luft deckte einen anderen Fehler auf. Strecke und Münzen hielten an, während die Figur weiterfiel. Eine vollständige Pause muss die relevante Simulation anhalten, auch die vertikale Bewegung.
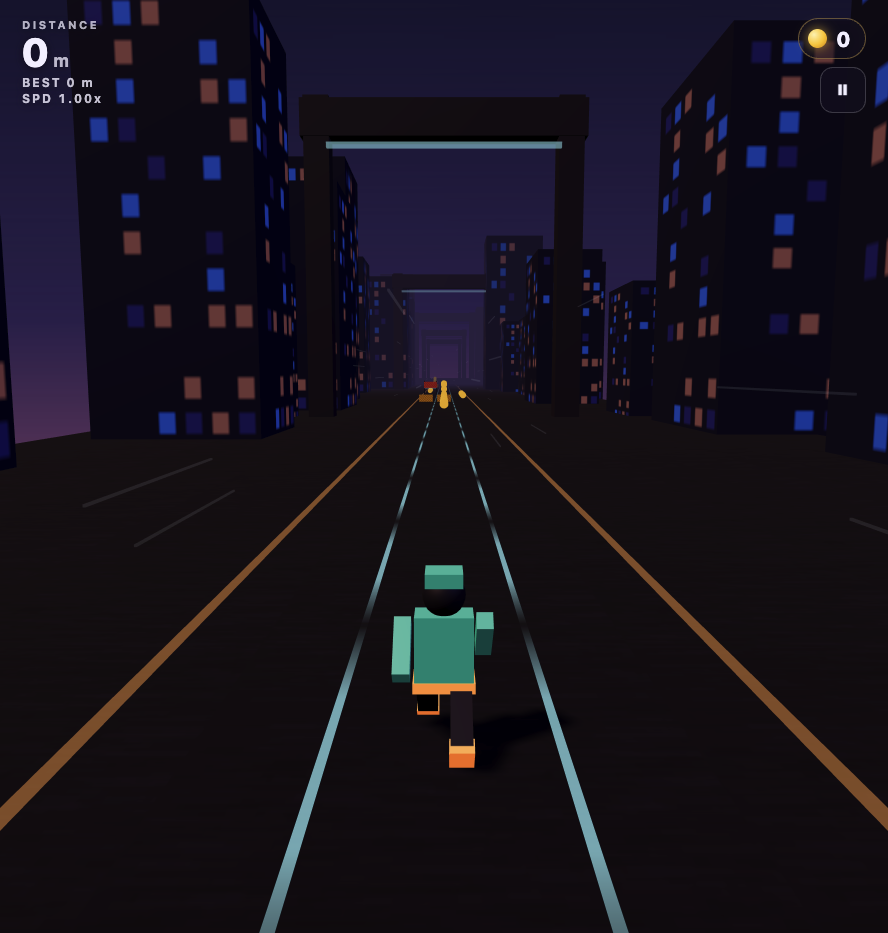
Ursprüngliche Stadtszene von MiMo Pro. Um den Pausenfehler zu entdecken, war ein Test mitten im Sprung nötig; ein ansprechendes Standbild hätte ihn nicht gezeigt.
Bei GLM sind zwei getrennte Erkenntnisse festzuhalten. Der Studio-Lauf scheiterte bei der Auslieferung, weil unser Validator Inline-Spielcode fälschlich als unzulässige Ressourcen-Markierung erkannte. Das war ein Plattformfehler. Es als Beleg zu zählen, dass GLM das Spiel nicht erzeugen konnte, wäre irreführend.
Wir stellten das unveränderte Original wieder her und prüften es separat. Begrenzte Prüfungen von Richtung, Touch und Pause funktionierten dort; nach einem Neustart konnte eine veraltete Münzanzeige stehen bleiben. Diese Prüfung sagt etwas über das Verhalten des Artefakts aus, macht aber den fehlgeschlagenen Studio-Ablauf nicht nachträglich zu einer erfolgreichen Auslieferung.
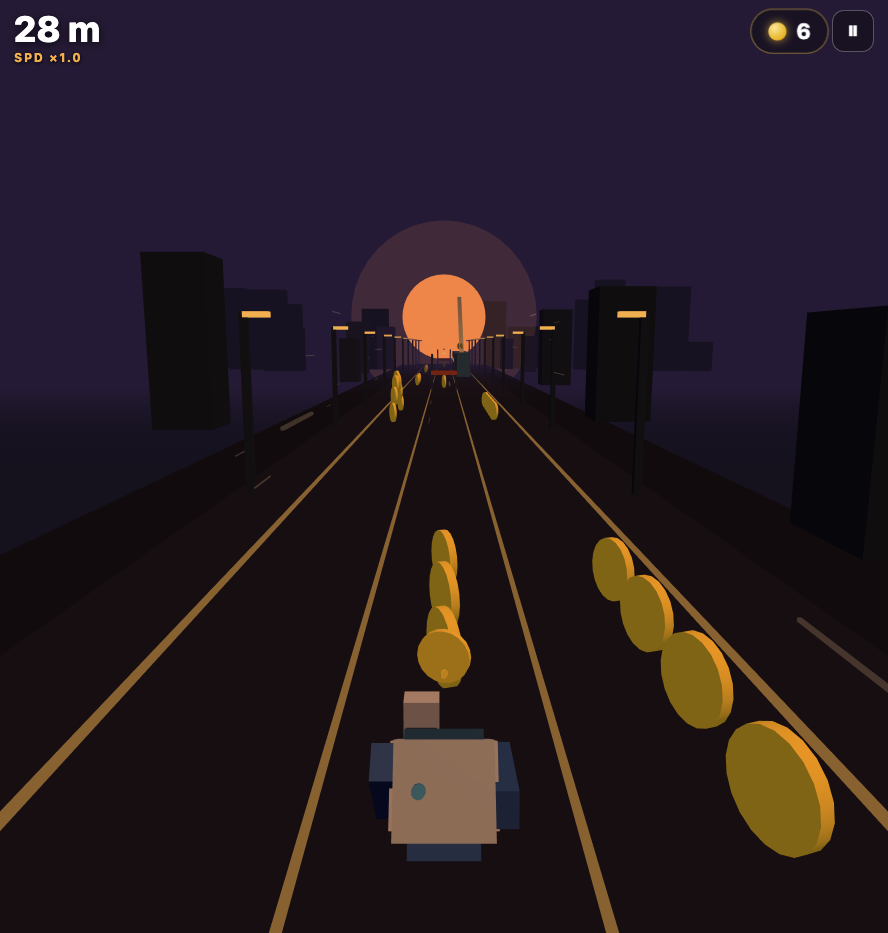
Separat geprüfte, wiederhergestellte GLM-Originalausgabe. Dieses Bild belegt keine erfolgreiche Auslieferung durch Studio.
Haiku 5.5 lieferte in diesem Beispiel seine Vorschau relativ schnell. Der Startbildschirm war zu sehen; nach einer ersten visuellen Begutachtung beendeten wir den Test. Tastatur, Touch, Kollision, Wiederbelebung und Neustart haben wir nicht vollständig abgenommen. Der erste Eindruck verdrängte unsere Präferenz für die MiMo-Experimente nicht, aber für ein endgültiges Qualitätsurteil zu Haiku fehlen uns Gameplay-Belege.
Diese Unterscheidung ist wichtig für ein Testprotokoll: Ausgeliefert, visuell begutachtet und funktional geprüft sind verschiedene Meilensteine.
Warum wird aus links plötzlich rechts?
Beim Grok-Runner trat der deutlichste Steuerungsfehler auf. Aus der mittleren Spur bewegte die Pfeiltaste Links die Figur auf die rechte Bildschirmseite. Links-Wischen bewirkte dasselbe.
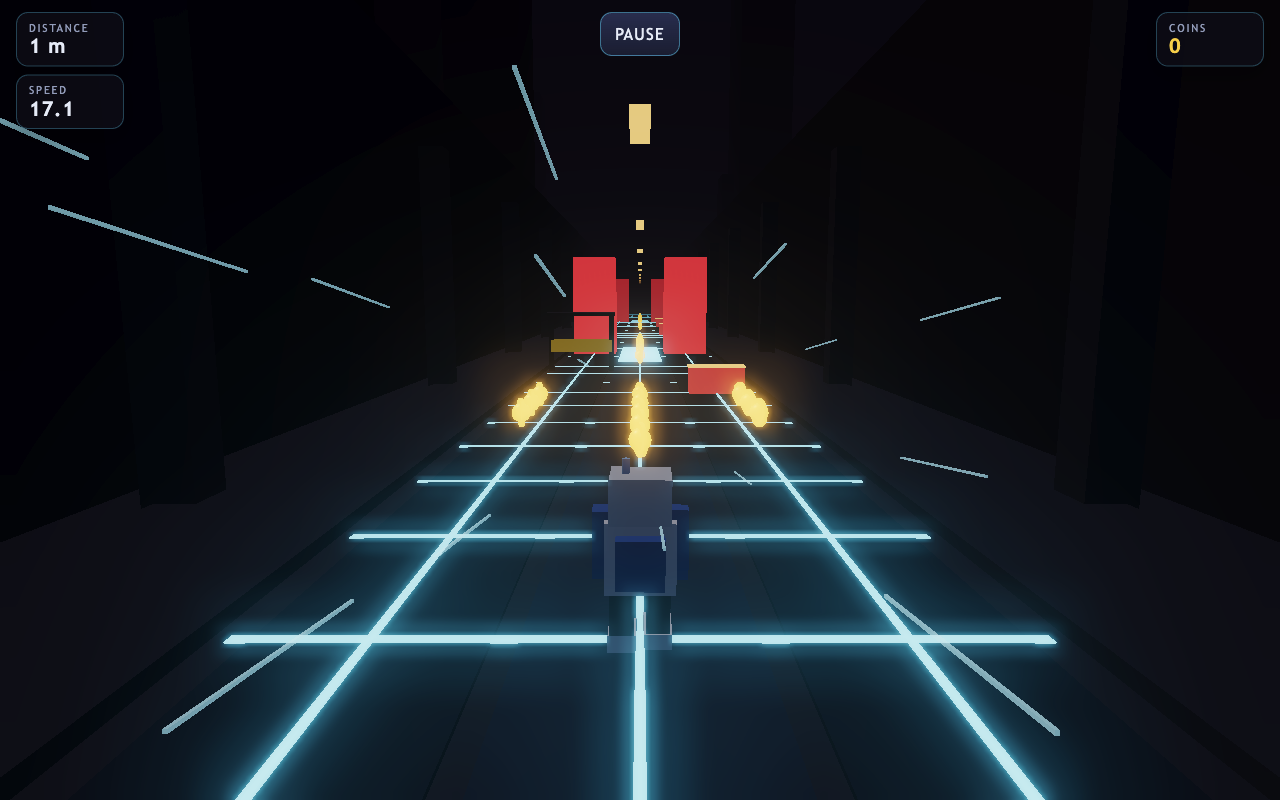
Vorher: Der Runner steht mittig.
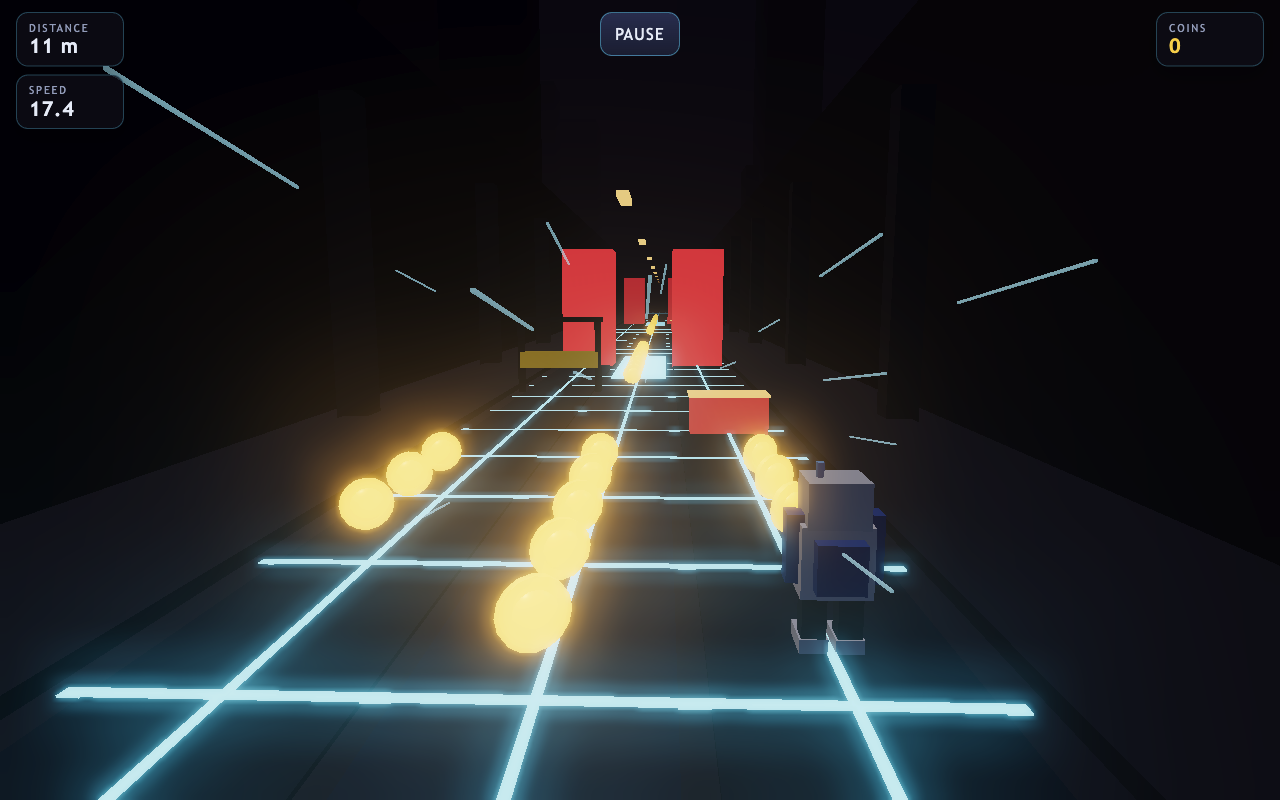
Nach Pfeil links: Der Runner ist klar rechts zu sehen. Beide Aufnahmen zeigen den unveränderten generierten Build.
Der Quellcode erklärte den Fehler: Für „links“ bewegte der Handler die Figur in Richtung der negativen Welt-X-Achse. Wegen der Kamerarichtung sah diese Bewegung auf dem Bildschirm wie eine Bewegung nach rechts aus. Tastatur und Touch verwendeten dieselbe Spursteuerung und übernahmen daher beide den Fehler.
Für den Spieler zählt die sichtbare Strecke als Bezugspunkt. Eine abnehmende Koordinate belegt keine korrekte Bewegung nach links. Bei einer Verfolgerkamera muss außerdem geprüft werden, wo die Figur relativ zu den Spuren steht, da sie auf dem Bildschirm mittig bleiben kann, während sich die Strecke bewegt.
Ein separates Rennexperiment zeigte eine Schwäche unserer Bewertung. Eine automatisierte Steuerung konnte die vertauschte Lenkung ausgleichen und eine Runde beenden. Jetzt prüfen wir jede Richtung einzeln und beginnen dafür jeweils neu. Die Strecke erfolgreich zu beenden hatte die Beschriftungen der Steuerung nicht verifiziert.
Was zeigte DeepSeek V4 in unserem Runner-Test?
Nach einer kurzen Bestätigung dauerte der Bau des aktuellen Runners etwa sieben Minuten. Wir prüften das Original in der Webvorschau:
- Richtungen: Pfeil links, Pfeil rechts, A und D bewegten die Figur auf die jeweils richtige sichtbare Spur. Wiederholte Eingaben stoppten an der äußeren Spur.
- Touch: Wischbewegungen nach links und rechts funktionierten in simuliertem Hoch- und Querformat. Wischen nach oben ließ die Figur springen; Wischen nach unten brachte sie in eine Rutschbewegung.
- Hindernisse: Bei einer Tastaturrunde wurde eine Bodenbarriere übersprungen, unter einer Überkopfstange durchgerutscht und die sichere Spur neben dem Riesenhindernis genommen.
- Münzen und Wiederbelebungen: Das Einsammeln begann beim Erreichen der Münzen. Eine Wiederbelebung zog verdiente Münzen ab und setzte den Lauf sicher fort. War sie nicht bezahlbar, wurden weder Münzen noch ein Einsatz verbraucht.
- Pause und Neustart: Beim Pausieren mitten im Sprung blieben Höhe und Strecke konstant, und Eingaben für die Strecke wurden blockiert. Ein Neustart setzte die mittlere Spur, Strecke und sichtbaren Münzen zurück.
Ein Lauf mit Hindernissen ging über 216 Meter hinaus; dabei wurden 51 Münzen gesammelt. Die Browser-Automatisierung verwendete normale Spieleingaben. Für dieses Ergebnis haben wir weder Koordinaten noch Punktestand oder Kollisionszustand verändert.
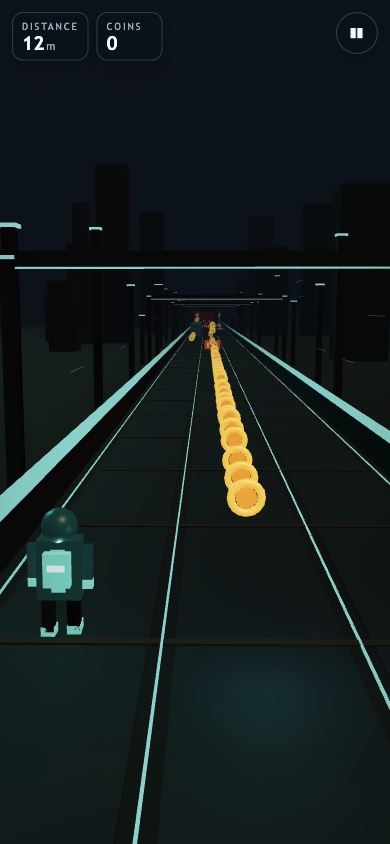
Nach einem Wischen nach links erreicht die Figur in der Hochformat-Simulation im Browser die sichtbare linke Spur. Die Kompatibilität mit einem echten Smartphone wurde nicht getestet.
Wir haben weder jede zufällige Hindernisfolge noch Dachstrecken, Wiederbelebungsgrenzen oder späte Spielzustände vollständig getestet. Im geprüften Umfang war dies ein funktionierender Prototyp mit vielversprechendem Umgang mit Regeln.
Spiellogik, Grafik und Lesbarkeit sollte man getrennt beurteilen
Im DeepSeek-Runner waren wichtige Objekte unterscheidbar: eine türkisfarbene Figur, helle Spurbegrenzungen, Goldmünzen und kontrastreiche Gefahren. Die dunkle, spärlich gestaltete Umgebung und einfachen Gebäude ließen viel Raum für visuelle Verbesserungen. Aus diesem Einzelergebnis lässt sich nicht allgemein ableiten, DeepSeek sei bei Logik besser als bei Grafik.
Unser separates Experiment Neon Harbor Sprint hatte einen starken Neon-Look, doch Autoform und Straße waren schwerer zu erkennen. Eine Überarbeitung für bessere Leistung verringerte die Renderauflösung, erhöhte die Reaktionsgeschwindigkeit und verlor zugleich an Konturenschärfe.
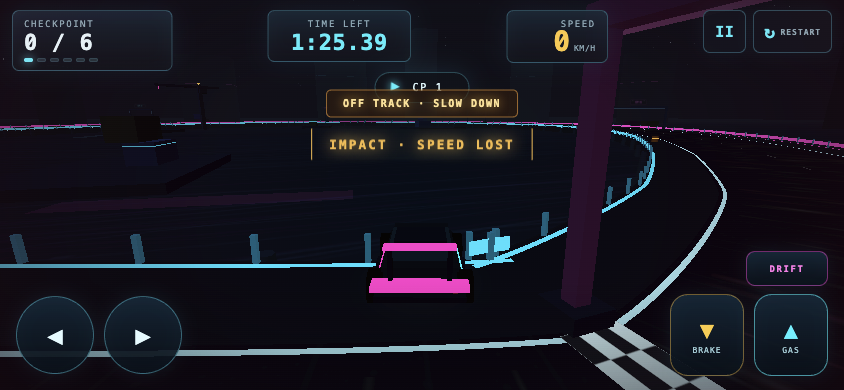
Ein separater DeepSeek-Rennprototyp. Er basierte auf einem anderen Auftrag und gehört nicht zum Vergleich der gemeinsamen Runner-Aufgabe.
Wir kehrten zum Runner zurück, weil ein anderes Spiel den Vergleich erschwert hätte. Der Racer vermittelte trotzdem eine nützliche Lektion: Beurteile Figur, Gefahren und Spurbegrenzungen in tatsächlicher Spielgröße und während das Spiel in Bewegung ist. Effekte und Interface-Dekoration können mit schlechter Lesbarkeit einhergehen.
Sind Prompts und Skills zu einschränkend?
Unser Runner-Auftrag war bewusst detailliert, damit wir ihn wiederverwenden konnten. Ein normaler Creator sollte mit einer viel kürzeren Idee anfangen können. Dabei zu helfen, aus einer Idee einen brauchbaren Auftrag zu machen, gehört zu den Aufgaben des Produkts.
Wir haben keinen kontrollierten Vergleich zwischen kurzem und detailliertem Prompt durchgeführt. Die Prompt-Länge erklärt deshalb nicht allein die vertauschten Steuerungen. Der fehlerhafte Quellcode liefert eine direkte Erklärung über Kamera und Eingabe; andere Ergebnisse aus demselben Auftrag behandelten die Richtungen richtig.
Einige Einschränkungen schützen das Spielerlebnis: einheitliche Steuerung, Münzen nur bei tatsächlicher Berührung, vollständige Pause und sauberer Neustart. Andere Entscheidungen können offenbleiben, darunter Thema, Farbpalette, Kameradarstellung und Aufbau der Szene durch das Modell. Ein starrer Erstellungsablauf lässt möglicherweise zu wenig Raum, die erste Umsetzung anzusehen und zu verbessern. Mehr Gelegenheiten zur Überarbeitung sind einen Test wert; ihr Nutzen bleibt hier eine Hypothese.
Frühere Versuche zeigten, warum auch der Ablauf berücksichtigt werden sollte. Bei einem MiMo-Versuch war das Antwortlimit erreicht, bevor ein Spiel ausgeliefert wurde. Ein anderer programmierte zwar das Spiel, aber ein Fehler im Provider-Stream verhinderte die endgültige Auslieferung. Diese Fehlschläge hatten unterschiedliche Ursachen und sollten getrennt von Gameplay-Mängeln protokolliert werden. Außerdem können wir deshalb nicht jeden historischen Versuch als reinen A/B-Modelltest behandeln.
Ein Creator könnte mit diesem Auftrag beginnen:
Erstelle einen einfachen 3D-Runner mit drei Spuren. Ich möchte nach links und rechts ausweichen, über Barrieren springen und unter Balken hindurchrutschen können – mit Tastatur- oder Touch-Steuerung. Ich wünsche mir eine gut erkennbare Figur, befriedigende Münz-Aufhebungen und einen schnellen Neustart nach einem Sturz. Such Umgebung und visuellen Stil selbst aus.
Das ist ein Vorschlag für den Einstieg, nicht der ursprüngliche Vergleichsauftrag. Studio kann fehlende Regeln klären, den Auftrag bestätigen und Raum für kreative Entscheidungen lassen. Bei einem kurzen Spieltest lässt sich anschließend die nächste sinnvolle Überarbeitung erkennen.
Wie beeinflussen diese Tests unser nächstes Experiment?
Für uns umfasst Optimierung jetzt auch Zuverlässigkeit bei der Auslieferung, Prüfaufwand und den Reparaturaufwand, den ein spielbares Ergebnis benötigt. Günstige Generierung ist nützlich, wenn ein Ergebnis gewöhnliche Eingaben zuverlässig verarbeitet und sich in einem handhabbaren Überarbeitungszyklus verbessern lässt.
Wir bewahren die Originalausgaben auf, protokollieren die erreichte Phase jedes Versuchs und prüfen Tastatur und Touch anhand des sichtbaren Verhaltens. In einem künftigen Vergleich könnten wir das Spiel unverändert lassen und jeweils eine Variable am Ablauf ändern, etwa die Länge des Auftrags oder die Zahl der Überarbeitungen. Diese Beobachtungen allein verraten nicht, welches Modell dabei am besten abschneidet.
Ein spielbares Beispiel findest du unter Colossal Runner. Die öffentlich verfügbaren, kuratierten Versionen enthalten spätere Reparaturen und sind von den hier gezeigten Originalexperimenten getrennt. Du kannst auch weitere Browser-Spiele ansehen, um Ideen für das eigene Spielerlebnis zu sammeln.
Hast du eine kleine Spielidee? Starte einen Auftrag im OpenGame Studio, stimme den grundlegenden Spielablauf ab und teste die erste Version mit echten Eingaben.
Quellenhinweis
Offizielle Quellen belegen die Modellnamen, den Veröffentlichungskontext und die Positionierung der Anbieter: DeepSeeks Veröffentlichung vom 17. Oktober, Grok 4.6, MiMo V2.6 Flash, MiMo V2.6 Pro, GLM 5.3 Flash, Claude Haiku 5.5 sowie das nicht getestete Spitzenmodell als Hintergrundbeispiel, Claude Opus 5.5.
Gameplay-Beobachtungen und Bauzeiten stammen aus unseren eigenen OpenGame-Studio-Experimenten und den aufbewahrten Originalen. Die acht Bilder sind unveränderte Aufnahmen dieser Prüfungen und zeigen ursprüngliche prozedurale Grafiken oder OpenGame-M0-Figurenressourcen unter CC0-1.0. Kein Bild stammt aus einer Produktvorführung eines Anbieters oder einer nachträglich verbesserten Rekonstruktion.